„Chwileczkę, sprawdzam”. Gdzie agent AI odpowiada szybciej i lepiej niż człowiek
Najczęstszy zarzut wobec voicebotów brzmi „za długo myśli”. To prawda, że agent AI rzadko odpowiada w pół sekundy. Ale zanim się odezwie, potrafi zrobić to, na co konsultant potrzebuje trzech zakładek i pół minuty: przeszukać kilka systemów, odfiltrować wyniki i przygotować propozycję, także wtedy, gdy nic nie pasuje dokładnie. O tym mówiłem na Mobile Trends, a tu rozpisuję to dokładniej.
W skrócie
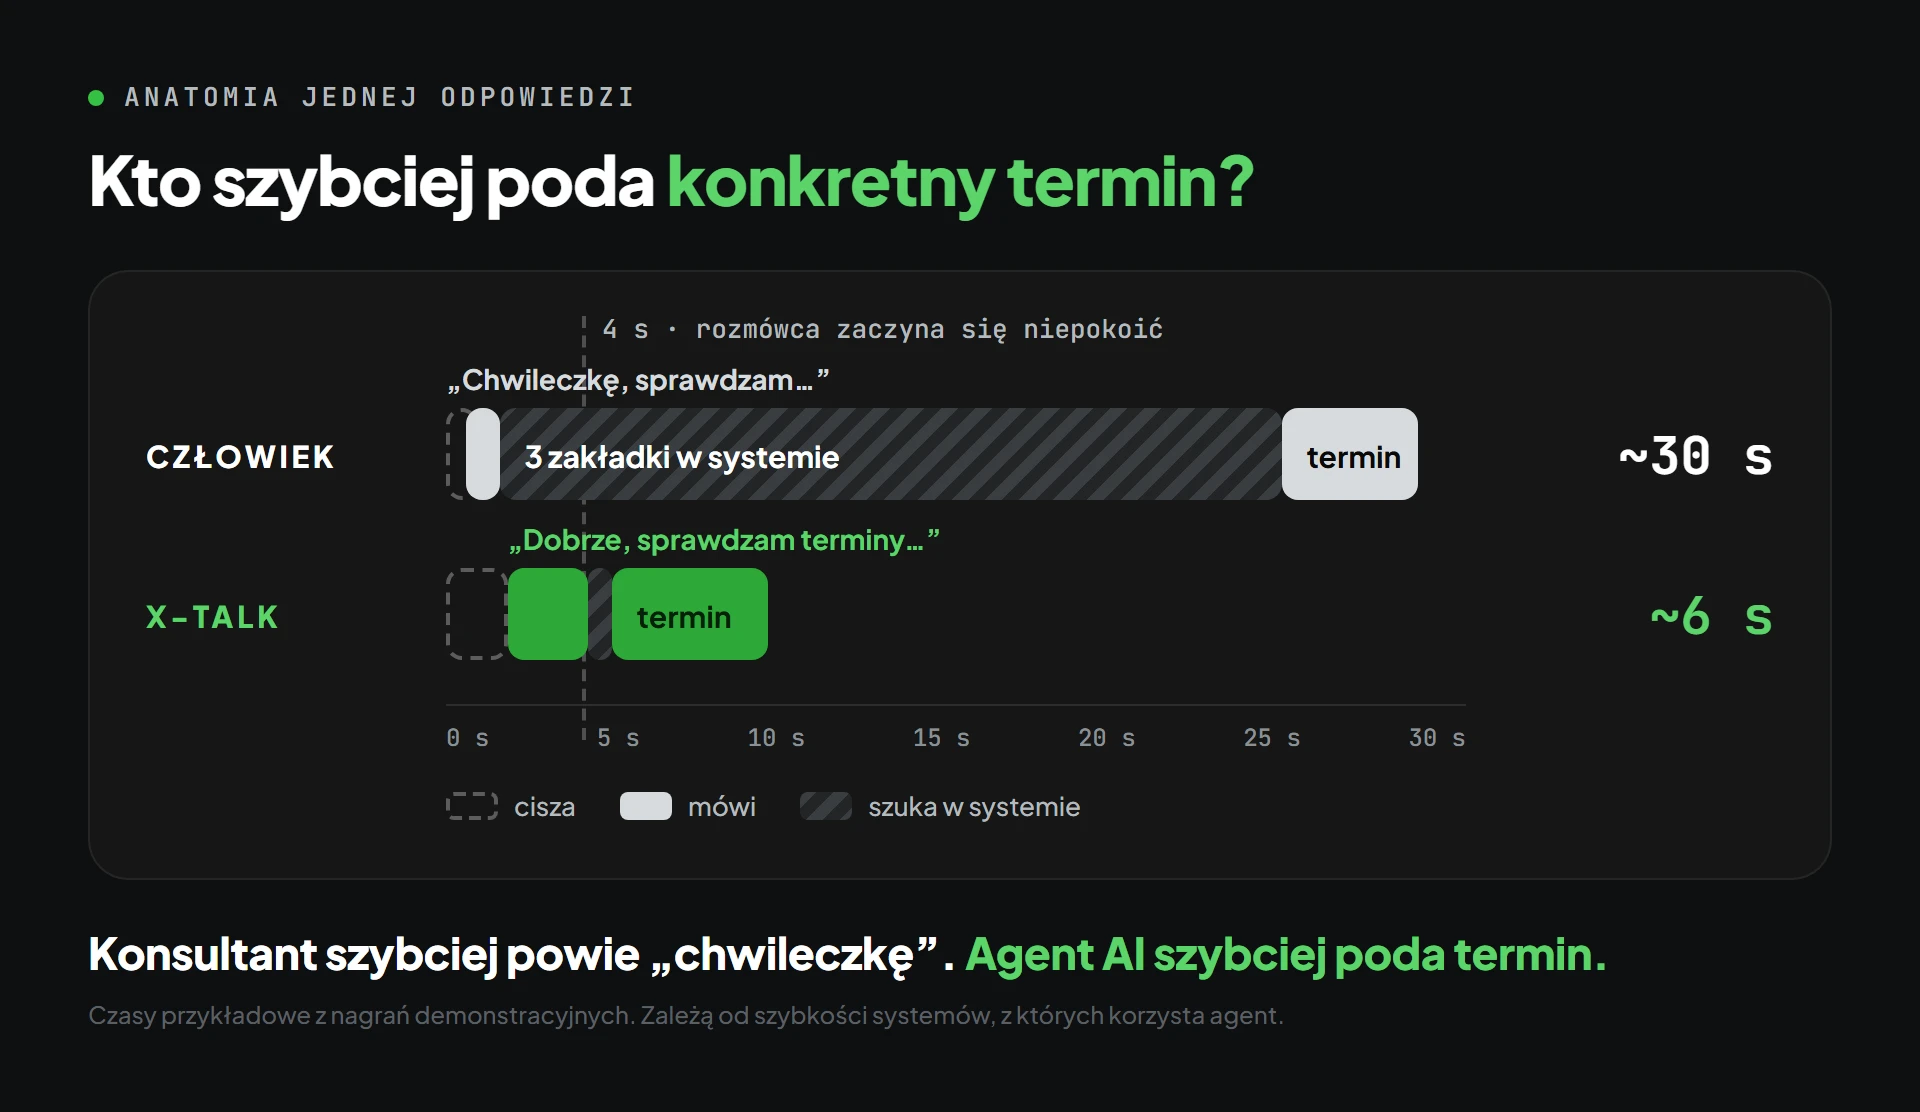
- Konsultant szybciej powie „chwileczkę”. Agent AI szybciej poda konkretną odpowiedź. Przy pytaniach, które wymagają sprawdzenia kilku rzeczy w systemach, agent zwykle kończy w kilka sekund, a człowiek w kilkadziesiąt.
- Agent mówi i szuka jednocześnie. Krótkie zdanie pomostowe („Dobrze, sprawdzam terminy…”) wypełnia czas, w którym w tle biegną zapytania do systemów.
- Jedno zdanie klienta to często kilka zapytań. API przyjmuje trzy pola, klient podaje siedem warunków. Agent rozbija prośbę na serię wywołań i resztę logiki (godziny, wykluczenia, ranking) wykonuje sam.
- Brak dokładnego dopasowania to nie koniec rozmowy. Agent poluzowuje warunki i proponuje najbliższe sensowne opcje: inny dzień, inne miasto, podobny produkt w budżecie.
- O szybkości odpowiedzi decydują też Twoje systemy. Model może być najszybszy na świecie, ale jeśli API odpowiada pięć sekund, klient czeka pięć sekund.
- API dla AI warto projektować pod negocjację, nie pod wyszukiwanie: przedziały zamiast pojedynczych wartości, warunki opcjonalne, „najbliższe pasujące” zamiast „dokładnie to”.
Dlaczego „agent AI myśli za długo” to tylko połowa prawdy?
Bo mierzymy niewłaściwą rzecz. Patrzymy, jak szybko pada pierwsze słowo, a powinniśmy patrzeć, jak szybko pada odpowiedź, z którą klient może coś zrobić.
Weźmy zdanie, od którego zacząłem prelekcję na Mobile Trends:
„Chciałbym zapisać się do alergologa w Toruniu, najlepiej w przyszłym tygodniu po szesnastej, ale nie w czwartek.”
Konsultant odpowie od razu: „Chwileczkę, sprawdzam”. Potem otwiera grafik lekarzy, przełącza się między dniami, sprawdza godziny, pomija czwartek, wraca do klienta. Realnie: kilkadziesiąt sekund, w których rozmówca słyszy klikanie albo ciszę.
Agent AI odezwie się po dwóch, trzech sekundach: „Dobrze, spróbuję znaleźć termin po szesnastej”. W tym czasie zapytania do systemu już lecą. Po kilku sekundach od końca wypowiedzi klienta pada konkret: „We wtorek mam 16:00, 16:15 albo 16:30. Który pasuje?”.
| Konsultant | Agent AI | |
|---|---|---|
| Pierwsza reakcja | od razu: „Chwileczkę, sprawdzam…” | po 2–3 s: „Dobrze, sprawdzam terminy…” |
| Co dzieje się potem | trzy zakładki, ręczne przeglądanie dni | kilka zapytań do systemu, filtrowanie w tle |
| Konkretna propozycja | po ok. 30 s | po ok. 6 s |
| Gdy nic nie pasuje | „Niestety, nie ma” albo kolejna runda szukania | od razu najbliższe alternatywy |
Czasy przykładowe, z nagrań demonstracyjnych pokazywanych na prelekcji. Zależą od tego, jak szybko odpowiadają systemy, z których korzysta agent.
Co agent AI robi w tych kilku sekundach?
Między końcem wypowiedzi klienta a odpowiedzią dzieje się kilka rzeczy jednocześnie, a nie po kolei:
- Słucha i rozumie. Rozpoznaje, że klient skończył mówić (to wcale nie jest proste, o czym niżej), i wyciąga z wypowiedzi warunki: specjalizacja, miasto, zakres dat, godziny, wykluczony dzień.
- Reaguje. Mówi krótkie zdanie pomostowe, żeby rozmówca wiedział, że jest słuchany. W X-TALK agent robi to tylko przed narzędziami, które faktycznie potrzebują chwili. Proste sprawdzenia wykonuje bez zapowiadania.
- Buduje zapytania. Zamienia zdanie klienta na wywołania API, często kilka, bo interfejs nie przyjmuje wszystkich warunków naraz.
- Pyta systemy. Grafik, katalog, system zgłoszeń. Tu czas zależy już od Twojego API. W demo z prelekcji zapytanie do grafiku trwało 128 ms.
- Filtruje i układa. Odrzuca terminy przed szesnastą i w czwartek, sortuje, wybiera dwa, trzy najlepsze.
- Proponuje. Odpowiada konkretem i od razu daje wybór.
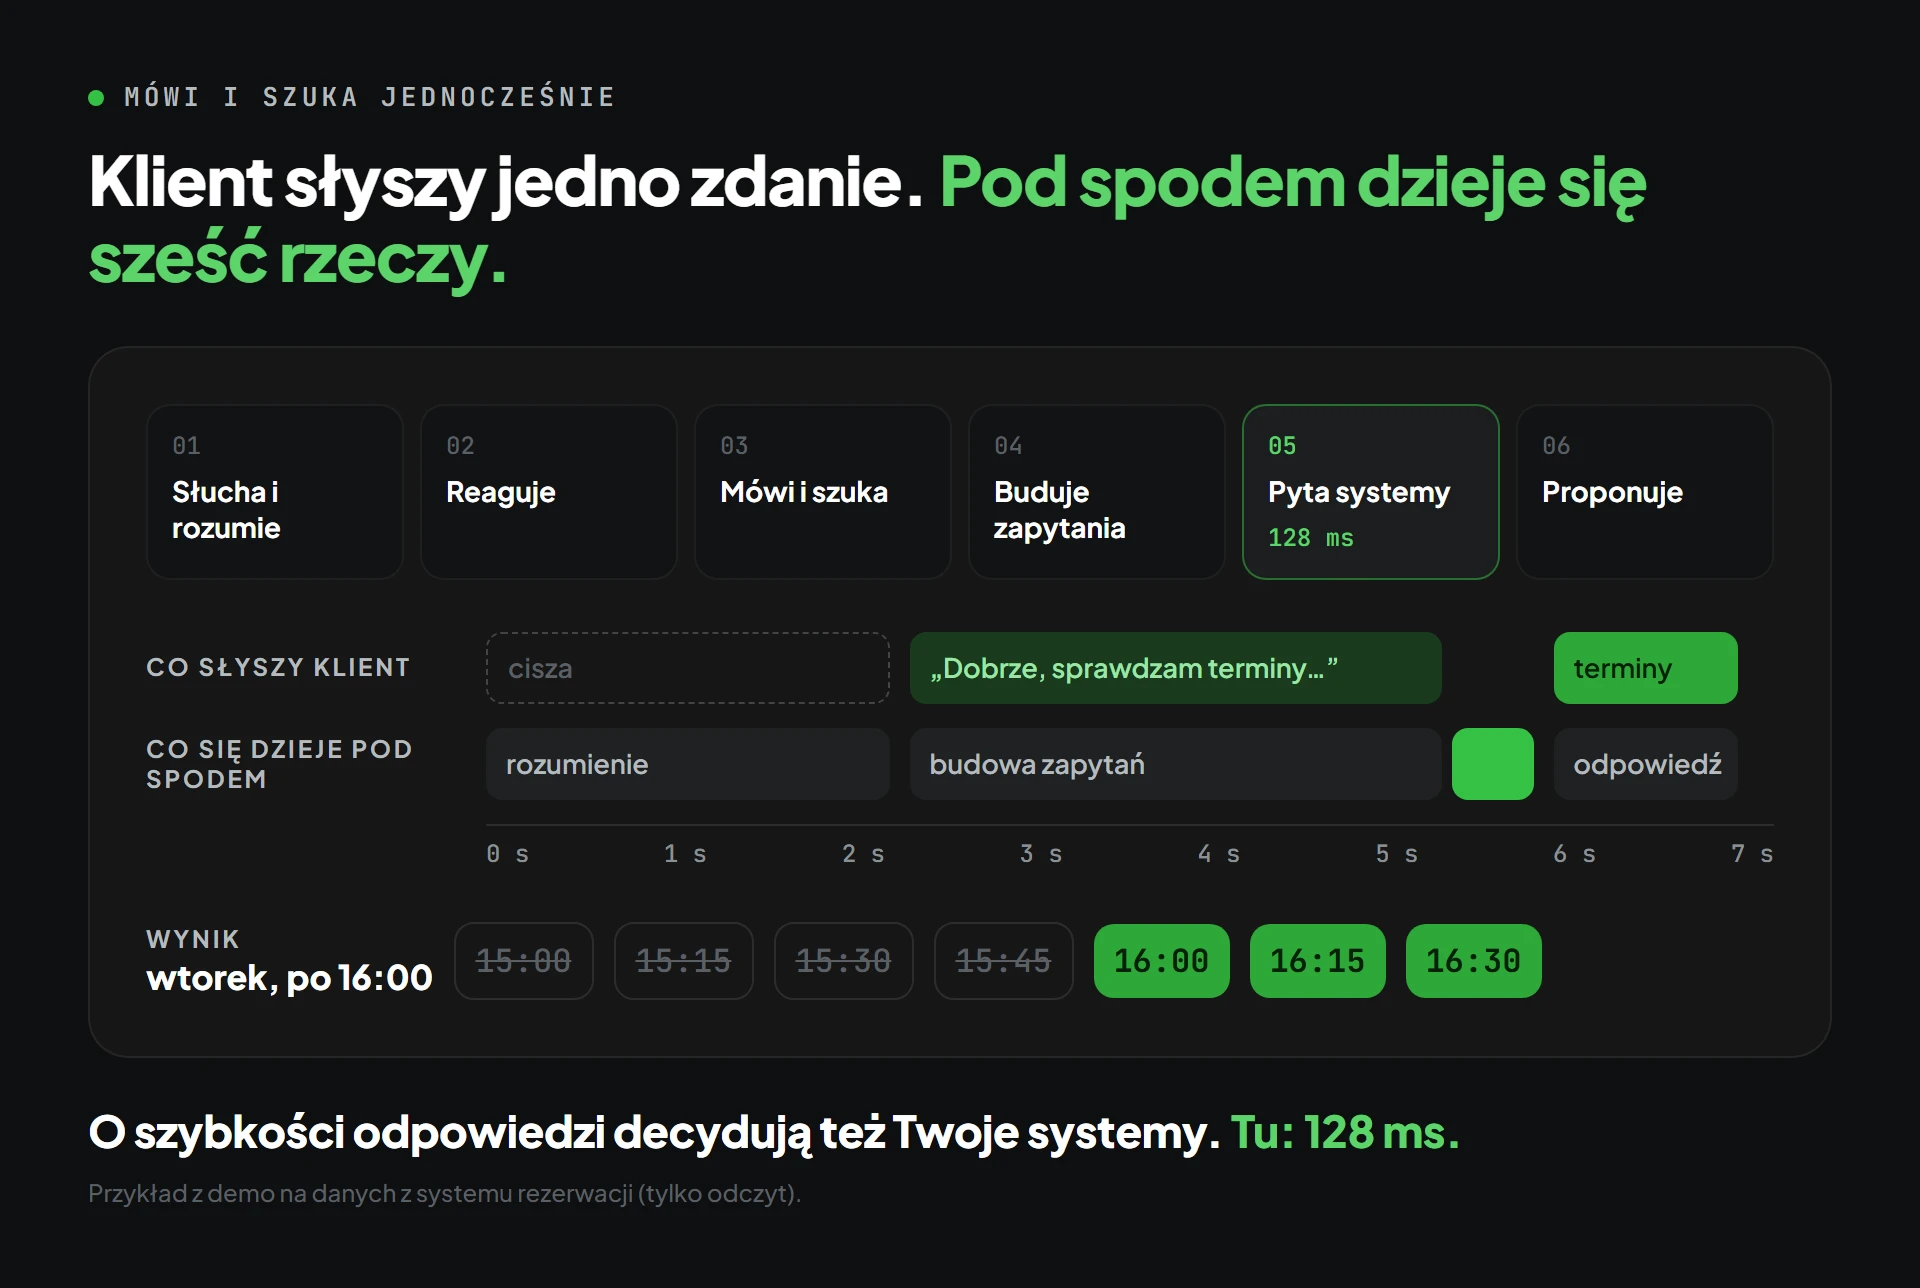
Kluczowe są kroki 2 i 3: agent mówi i szuka jednocześnie. Klient nie słucha ciszy, a odpowiedź jest gotowa, zanim zdanie pomostowe się skończy albo chwilę po nim.
Ile czasu ma agent na odpowiedź?
Mniej, niż się wydaje. Po mniej więcej sekundzie ciszy rozmówca zaczyna się niepokoić, po kilku pyta „halo?” albo powtarza pytanie. Dlatego w rozmowie głosowej nie optymalizuje się samego modelu, tylko kolejność operacji i liczbę przejść tam i z powrotem: co agent może powiedzieć od razu, co sprawdzić równolegle, a na co naprawdę trzeba poczekać.
Dlaczego jedno zdanie klienta to kilka zapytań do API?
Bo ludzie mówią warunkami, a systemy przyjmują pola.
W zdaniu o alergologu jest sześć, siedem warunków: miasto (i może okolica), specjalizacja, „przyszły tydzień” liczony od dzisiaj, godziny po szesnastej, wykluczony czwartek, czasem NFZ albo prywatnie. Typowe API grafiku przyjmuje trzy pola: miasto, specjalizację i jeden dzień. Wszystkie wymagane, bez przedziałów godzin.
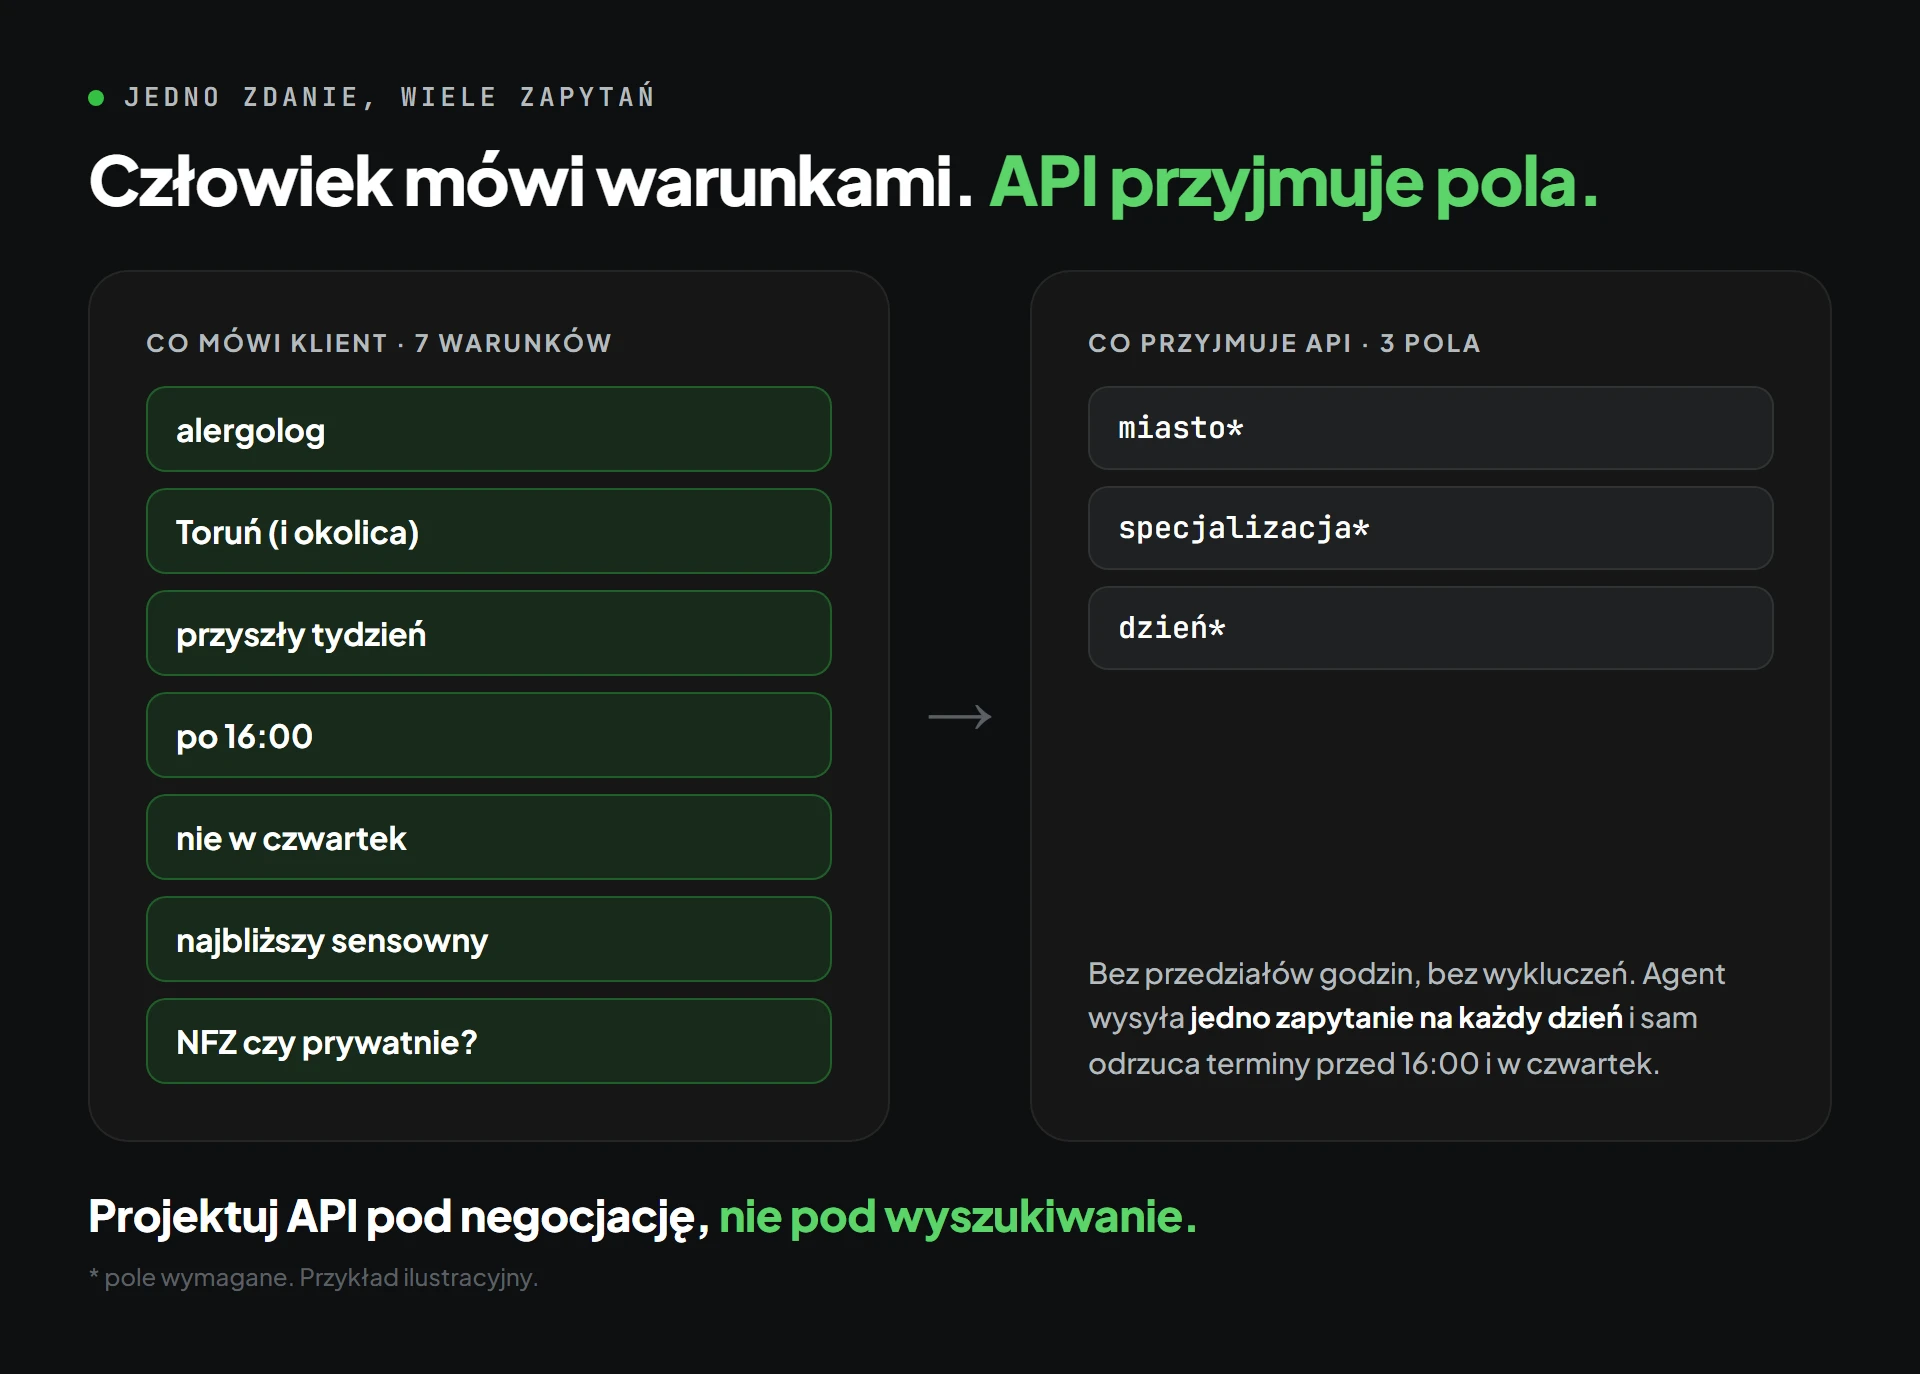
Co więc robi agent:
- wysyła jedno zapytanie na każdy dzień z zakresu (z pominięciem czwartku),
- pobiera wszystkie terminy,
- sam odrzuca te przed szesnastą, układa resztę od najwcześniejszej i wybiera najlepsze.
Naiwnie wyobrażamy sobie jedno wywołanie. W praktyce bywa ich pięć, siedem, dziesięć, plus filtrowanie na zebranych danych. Konsultant robi dokładnie to samo, tylko ręcznie, w kilku zakładkach. Agent robi to w czasie, w którym mówi „dobrze, sprawdzam”.
Co, jeśli nic nie pasuje dokładnie?
To moment, w którym agent najwyraźniej wygrywa z formularzem i często z człowiekiem.
Formularz wyszukiwania zwraca „brak wyników”. Zmęczony konsultant mówi „niestety nie ma” i czeka na kolejną propozycję klienta. Agent ma już w pamięci wszystko, co pobrał, więc od razu proponuje najbliższą sensowną opcję:
- Terminy: „Po szesnastej w przyszłym tygodniu nie ma wolnych miejsc. Najbliżej jest poniedziałek 15:45 albo wtorek tydzień później o 16:15. Mogę też sprawdzić Bydgoszcz, tam jest jutro 17:00.”
- Produkty: gdy żaden produkt nie spełnia wszystkich kryteriów, wyszukiwanie w X-TALK nie kończy się pustą listą. Agent najpierw zdejmuje filtry, które klient podał mimochodem, zostawiając te kluczowe (np. markę i model), a dopiero potem budżet, i pokazuje najbliższe oferty z informacją, czym się różnią.
- Rezerwacje i pakiety: gdy instruktor jest zajęty, agent proponuje innego w tym samym czasie albo ten sam w innym. Gdy klient pyta o kilka zajęć, porównuje pakiet z pojedynczymi lekcjami.
Kluczowe: agent mówi wprost, że to alternatywa, a nie udaje, że znalazł dokładnie to, o co proszono. Klient zachowuje decyzję, ale nie musi wymyślać kolejnego pytania.
Gdzie ta przewaga widać najbardziej?
Tam, gdzie odpowiedź wymaga połączenia kilku warunków i kilku źródeł:
- umawianie terminów: wizyty, serwisy, jazdy próbne, zajęcia w szkole narciarskiej,
- dobór produktu: budżet, parametry, dostępność, porównanie dwóch, trzech modeli,
- status i historia: zamówienie, zgłoszenie, poprzednia rozmowa w tej samej sprawie,
- przejazdy i grafiki: połączenia, opóźnienia, najbliższe kursy.
Tam, gdzie wystarczy jedno zdanie z regulaminu, przewaga szybkości jest mniejsza. Tam z kolei wygrywa dostępność: agent odbiera o każdej porze i nigdy nie ma kolejki.
Od czego zależy, jak szybko agent odpowie?
Od trzech rzeczy, z których tylko jedna to model:
- Wykrycie końca wypowiedzi. Agent musi wiedzieć, że klient skończył mówić, a nie tylko zrobił pauzę po „alergologa”. W cichym biurze wystarczy prosty próg głośności. W sklepie z chłodnią i kasą próg trzeba liczyć względem tła na bieżąco, a rozpoznawanie „po znaczeniu” trzeba dostroić tak, żeby agent nie wchodził w naturalne pauzy. To wiemy z nagrań rozmów produkcyjnych, nie z laboratorium.
- Twoje systemy. Jeśli API grafiku odpowiada w 128 ms, odpowiedź padnie szybko. Jeśli w pięć sekund, klient poczeka pięć sekund, niezależnie od modelu. Szybkość rozmowy głosowej projektuje się także w danych.
- Liczba kroków. Każde dodatkowe zapytanie to milisekundy z budżetu. Dlatego warto dać agentowi narzędzia, które zwracają od razu to, czego potrzebuje, zamiast surowych danych do mielenia.
Jak zaprojektować API, z którego dobrze korzysta agent AI?
Pod negocjację, nie pod wyszukiwanie. Ludzie rzadko pytają o dokładną wartość. Pytają o zakres i liczą na podpowiedź.
- Przedziały zamiast pojedynczych wartości:
od–dodla dat i godzin zamiast jednego dnia. - Warunki opcjonalne zamiast wymaganych: miasto bez specjalizacji, specjalizacja bez miasta.
- „Najbliższe pasujące” zamiast „dokładnie to”: jedno pole
available_fromzamiast pętli po dniach zdejmuje agentowi połowę pracy i połowę budżetu czasowego. - Krótkie, uporządkowane odpowiedzi: tylko pola potrzebne do rozmowy, już posortowane.
Jeśli Twój system tego nie umie, nie szkodzi. Agent zrobi to sam, kilkoma zapytaniami. W X-TALK takie narzędzie zbuduje Copilot z dokumentacji API, razem z testami, które sprawdzą, czy agent wybiera właściwe terminy. Więcej w artykule o narzędziach własnych i w testach automatycznych agentów.
A gdy agent nie znajdzie odpowiedzi?
Przekazuje rozmowę człowiekowi, ale ze stanem, a nie od zera. Konsultant nie zaczyna od „w czym mogę pomóc”, tylko od „widzę, że szuka pan alergologa w Toruniu, w przyszłym tygodniu po szesnastej”. Transkrypcja jest jedna dla całej rozmowy, a każde przekazanie trafia do statystyk.
To ważne z jeszcze jednego powodu: kolejka przekazań to backlog automatyzacji. Pokazuje, czego agent jeszcze nie umie, posortowane według częstotliwości. Więcej o tym w artykule kiedy AI powinno oddać rozmowę człowiekowi i na stronie konsoli konsultanta.
Najczęstsze pytania
Czy agent AI zawsze odpowiada szybciej niż człowiek?
Nie. Pierwsze słowo konsultant zwykle powie szybciej. Agent wygrywa wtedy, gdy odpowiedź wymaga sprawdzenia kilku rzeczy w systemach: terminu, dostępności, statusu, porównania. Wtedy konkretną propozycję daje zwykle w kilka sekund, a człowiek w kilkadziesiąt.
Co agent mówi, kiedy szuka?
Krótkie, naturalne zdanie pomostowe, np. „Dobrze, sprawdzam terminy po szesnastej”. W X-TALK agent zapowiada tylko narzędzia, które potrzebują chwili, i nie powtarza w kółko tego samego zdania. Szybkie sprawdzenia robi bez komentarza.
Czy agent może zaproponować coś, o co klient nie pytał?
Może zaproponować najbliższą alternatywę, gdy nic nie pasuje dokładnie: inny dzień, inne miasto, podobny produkt w budżecie. Zawsze mówi wprost, że to alternatywa, i zostawia wybór klientowi.
Co, jeśli nasze API jest wolne?
Wtedy to ono wyznacza czas odpowiedzi. Agent może ukryć część opóźnienia zdaniem pomostowym, ale nie całość. Zwykle pomaga narzędzie, które pobiera dane hurtem albo z cache, zamiast wielu pojedynczych zapytań. Pokażemy to na Twoim API w PoC.
Czy to działa tylko w rozmowach głosowych?
Nie. Ta sama logika (rozbicie prośby na zapytania, filtrowanie, alternatywy) działa na czacie, w WhatsAppie, w Teams i w aplikacji mobilnej. W głosie najbardziej widać różnicę w czasie, bo tam liczy się każda sekunda ciszy.
Gdzie zobaczyć, jak to działa?
Zadzwoń do agenta X-TALK pod numer +48 732 106 896 albo umów PoC na swoich danych: pokażemy rozmowę od pytania klienta do konkretnej propozycji, z czasami każdego kroku.