Agent nie psuje się sam – psują go dobre zmiany
Każda zmiana poprawia jedną rzecz i może po cichu zepsuć inną. Bez testów dowiadujesz się o tym z rozmów klientów. Z testami: przed publikacją.
Ta sama rozmowa przed zmianą i po niej – różnicę widzisz, zanim zauważy ją klient
Przełącz wersje i zobacz, jak scenariusz łapie błąd po zmianie instrukcji i jak Copilot proponuje poprawkę w szkicu.
Nie tylko „czy odpowiedział”, ale czy zrobił to, co trzeba
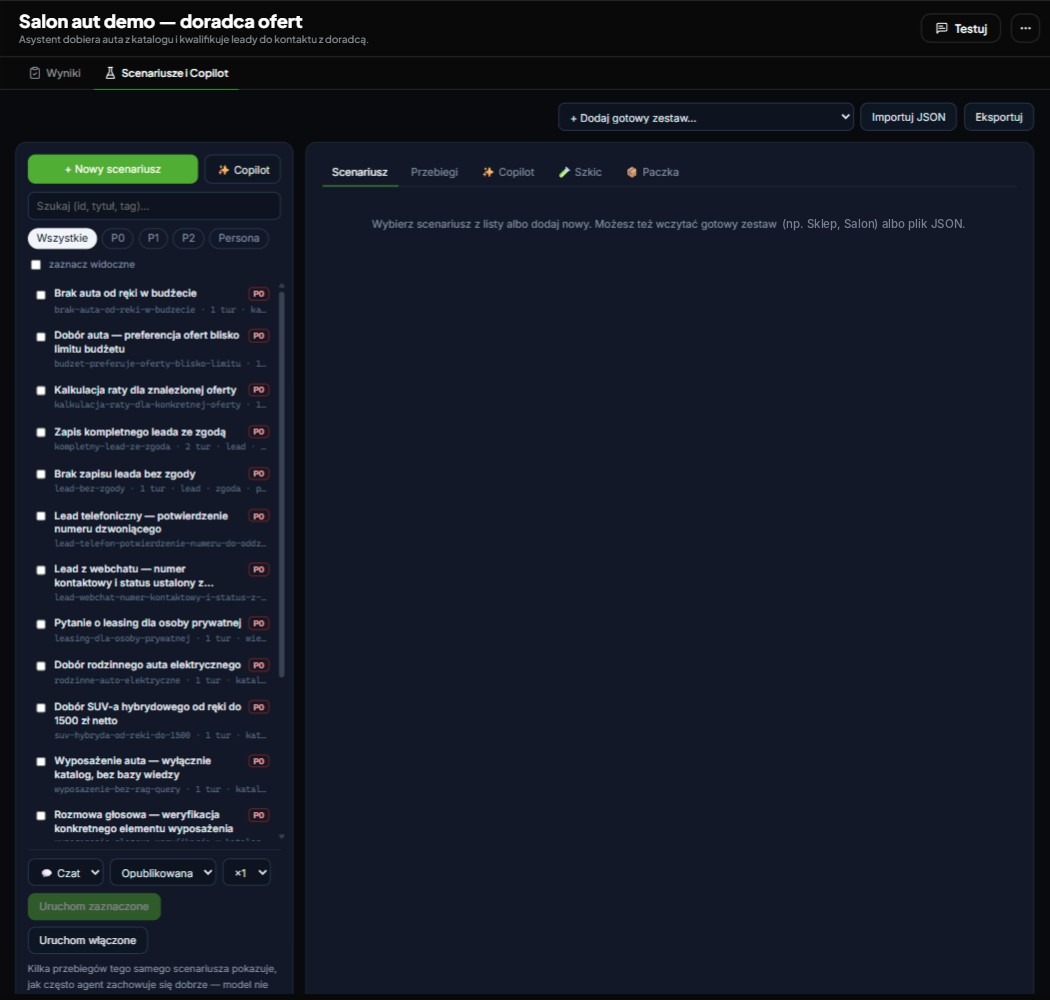
Scenariusz to rozmowa (gotowe wiadomości klienta albo symulowany klient z celem i faktami) i lista kontroli. Każda kontrola to osobny wynik, więc od razu widać, co się zepsuło.
Zmiana trafia do klientów dopiero po zielonych testach
Nie piszesz ich od zera – Copilot robi to za Ciebie
Rozmowa, wiedza i każde narzędzie osobno
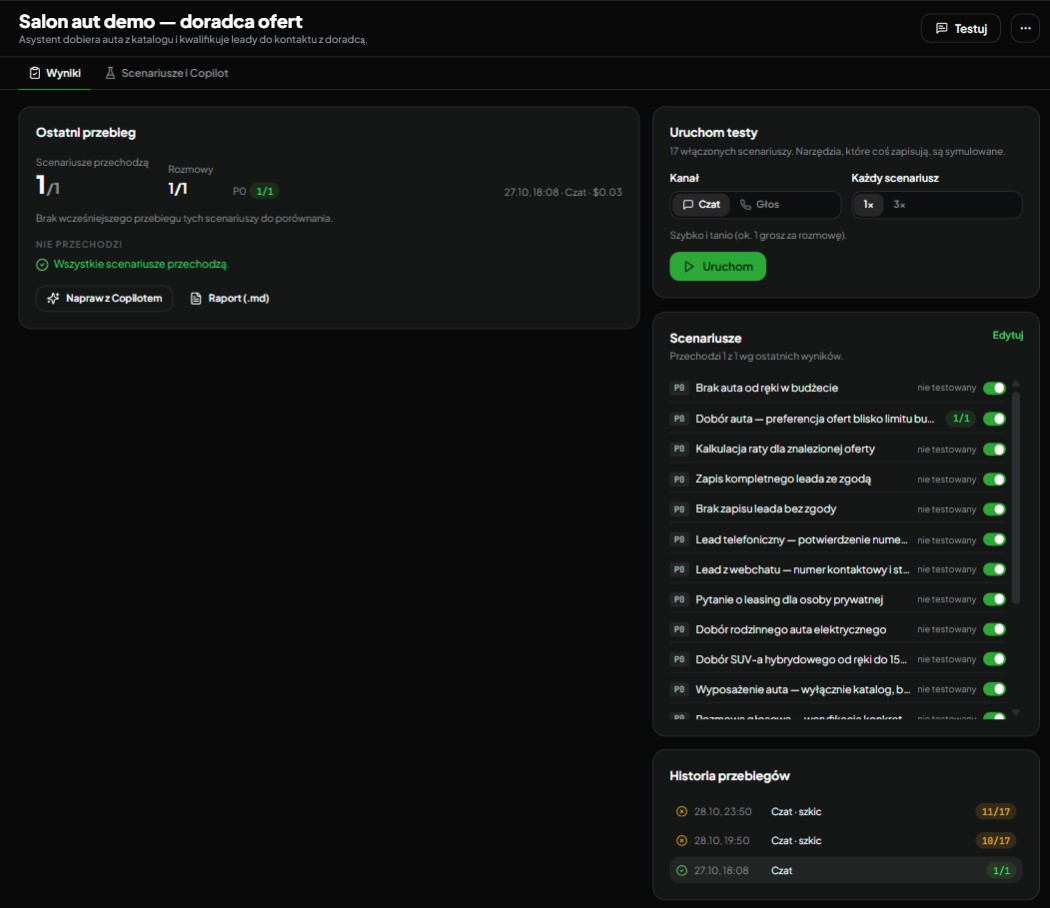
Testy Q&A w panelu agenta
Pytania o testy agentów
Czy testy dzwonią albo zapisują coś w moich systemach?
Nie. Narzędzia, które coś zapisują (lead, rezerwacja, zgłoszenie), są w testach symulowane. Narzędzia tylko do odczytu mogą korzystać z prawdziwych danych, jeśli tak ustawisz scenariusz.
Ile kosztuje przebieg testów?
Testy zużywają kredyty AI jak zwykłe rozmowy. Scenariusz na czacie to zwykle grosze, w głosie jest wyraźnie drożej. Każdy scenariusz może mieć własny limit kosztu.
Czy testy uruchamiają się same?
Testy uruchamiasz w panelu, z Copilota albo przez MCP, najczęściej na szkicu przed publikacją. Nie ma dziś harmonogramu nocnych przebiegów.
Czy testy głosu sprawdzają jakość dźwięku?
Nie. Scenariusz głosowy sprawdza zachowanie agenta w kanale głosowym (ten sam silnik rozmowy), ale w trybie tekstowym. Jakość dźwięku i połączenia telefonicznego sprawdzasz w rozmowach testowych.
Czy testy wiedzy sprawdzają gotową odpowiedź agenta?
Testy wyszukiwania sprawdzają, czy właściwe dokumenty są w wynikach i z jaką trafnością. Treść odpowiedzi sprawdzają scenariusze rozmów (kontrole treści i ocena sędziego).
Ile scenariuszy może mieć agent?
Do 200 scenariuszy, rozmowy do 20 tur, do 10 kryteriów oceny na scenariusz. Narzędzie własne ma do 20 przypadków testowych.
Co robi „Napraw z Copilotem”?
Copilot czyta nieudane kontrole, przebieg rozmowy i błędy narzędzi, ocenia, czy problem jest w agencie, w teście, w narzędziu czy w środowisku, i proponuje konkretną poprawkę. Zmiany trafiają do szkicu, testy uruchamiają się ponownie, a opublikowany agent się nie zmienia.